La réponse courte
Oui, un dépôt Git peut servir de mémoire durable à une IA, sans que vous touchiez à Git. Vous parlez, l’IA modifie les fichiers et enregistre les versions. Le projet garde tout, avec l’historique.
Mais ce système reste risqué pour un débutant : la première configuration manipule des clés et des secrets, l’IA peut oublier d’enregistrer ou de récupérer la dernière version, et deux ordinateurs peuvent modifier la même information. La bonne solution n’est probablement pas d’apprendre Git, mais d’utiliser une couche qui synchronise automatiquement et explique les conflits en langage normal. Plusieurs projets open source commencent à le faire.
Cela vous semble déjà trop compliqué ? Faites-vous aider.
À quoi ressemble ce travail au quotidien
Commençons par une scène concrète.
Vous dites à votre IA : « Montre-moi notre comparaison des fournisseurs. »
L’IA cherche le bon fichier dans le dépôt. Elle lance une petite version locale et vous donne un lien. Vous l’ouvrez dans Chrome. Le document s’affiche, propre, avec ses tableaux.
Vous regardez et vous dites : « La deuxième partie est trop chargée. Mets mieux le prix en valeur. »
L’IA modifie le fichier. Vous rechargez la page : la nouvelle version s’affiche. Si elle vous convient, l’IA l’enregistre dans Git, avec un message du type « Comparaison fournisseurs : prix mis en avant ».
À aucun moment vous n’avez ouvert un fichier Markdown ni tapé une commande. Et pourtant, la version d’avant existe toujours. Le document ne vit pas dans une conversation : il vit dans le projet.
Pour les mots techniques, deux définitions suffisent. Un dépôt (repository en anglais) est un dossier dont Git garde toutes les versions. Un commit est une version enregistrée, avec sa date et un petit message. GitHub est un service en ligne qui garde une copie du dépôt.
Pourquoi ce système reste dangereux pour un débutant
Ce circuit marche très bien quand tout est en place. Le problème, c’est tout ce qui se passe quand ce n’est pas le cas. Voici les trois pièges que nous avons rencontrés.
1. La première configuration
Pour que l’IA puisse envoyer vos fichiers sur GitHub, il faut une autorisation. Selon la méthode, cela s’appelle un token, une clé SSH, une connexion OAuth. Pour un débutant, ce sont des mots qui font peur, et avec raison.
Un token GitHub est un peu comme une clé de maison. Certains ne s’affichent qu’une seule fois au moment de leur création. Si vous le copiez dans une conversation pour « aider » l’IA, il se retrouve dans l’historique de cette conversation. Nous en reparlons dans le prochain article.
Il y a aussi l’inverse : un fichier secret qui part dans le dépôt par erreur. Beaucoup de projets ont un fichier .env qui contient des mots de passe, et un fichier .gitignore qui dit à Git « ne prends jamais ces fichiers ». Si le .gitignore est mal réglé, le secret est envoyé sur GitHub avec le reste. Et même si on le supprime ensuite, il reste dans l’historique.
2. L’IA oublie des étapes
Une IA peut modifier un fichier et oublier de l’enregistrer (le commit) ou de l’envoyer (le push). Tout semble fait, mais rien n’est sauvegardé ailleurs que sur votre ordinateur.
Elle peut aussi commencer à travailler sans récupérer la dernière version (le pull). Elle travaille alors sur une copie ancienne, sans le savoir.
3. Plusieurs ordinateurs
C’est le piège le plus courant. Vous travaillez le matin sur l’ordinateur du bureau, le soir sur votre portable. L’un a la nouvelle version, l’autre l’ancienne. Les deux modifient le même prix. Git ne sait pas lequel garder : c’est un conflit.
Et Git l’annonce ainsi :
CONFLICT (content): Merge conflict in fournisseurs.md
Pour quelqu’un qui ne connaît pas Git, ce message ne veut rien dire. Le bon message serait plutôt :
« Deux ordinateurs ont modifié le prix. Une version indique 60 €, l’autre 65 €. Laquelle faut-il conserver ? »
Ce que devrait faire une bonne couche « sans Git »
Pour le grand public, la solution n’est probablement pas « apprendre Git ». C’est plutôt une couche au-dessus de Git, qui fait automatiquement les bons gestes :
- au début du travail : récupérer la dernière version ;
- après une modification importante : enregistrer une version ;
- à la fin du travail : tout envoyer sur le serveur.
Et quand deux versions s’opposent, elle devrait poser la question en langage normal, comme dans l’exemple du prix.
Cette couche peut être une application. Elle peut aussi être l’IA elle-même, si on lui donne des règles claires : « Avant de commencer, récupère la dernière version. Avant de finir, vérifie que tout est envoyé. »
Trois projets qui cachent déjà une partie de Git
Nous avons lu la documentation de trois projets open source. Ils ne font pas tous la même chose, et ils sont récents. Mais ils montrent qu’une idée commence à apparaître : Git peut rester dessous, l’humain n’a pas forcément besoin de le voir.
OpenKnowledge : un éditeur visuel, avec Git en dessous
OpenKnowledge est un éditeur de documents. On écrit comme dans Google Docs ou Notion, mais chaque document est un simple fichier texte sur votre ordinateur, au format Markdown (du texte avec quelques signes pour les titres et le gras). Il existe en application de bureau (macOS, Windows, Linux) et en version web locale.
Ce qui nous intéresse, c’est la place de l’IA. Des agents comme Claude ou Codex peuvent lire et modifier les mêmes documents, à côté de vous. Chaque modification est attribuée : on sait si elle vient de vous, d’un agent, ou d’une synchronisation.
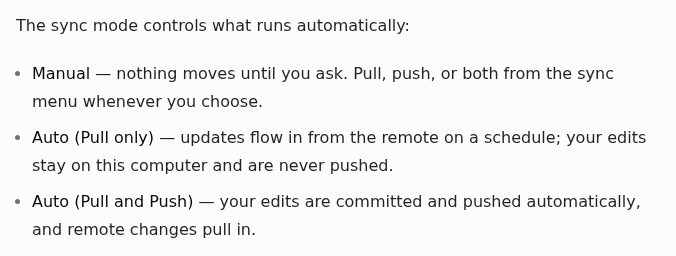
La synchronisation avec GitHub est optionnelle. Elle a trois modes : manuel, automatique en réception seulement, ou automatique dans les deux sens. Dans ce dernier mode, l’application enregistre et envoie vos modifications toute seule, toutes les minutes par défaut.
En cas de conflit, le fichier concerné est bloqué et l’application affiche les deux versions côte à côte pour choisir. C’est plus clair qu’un message Git brut, mais cela reste une comparaison de texte, pas encore la question simple sur le prix.
GitMemo : ranger ce qui est temporaire
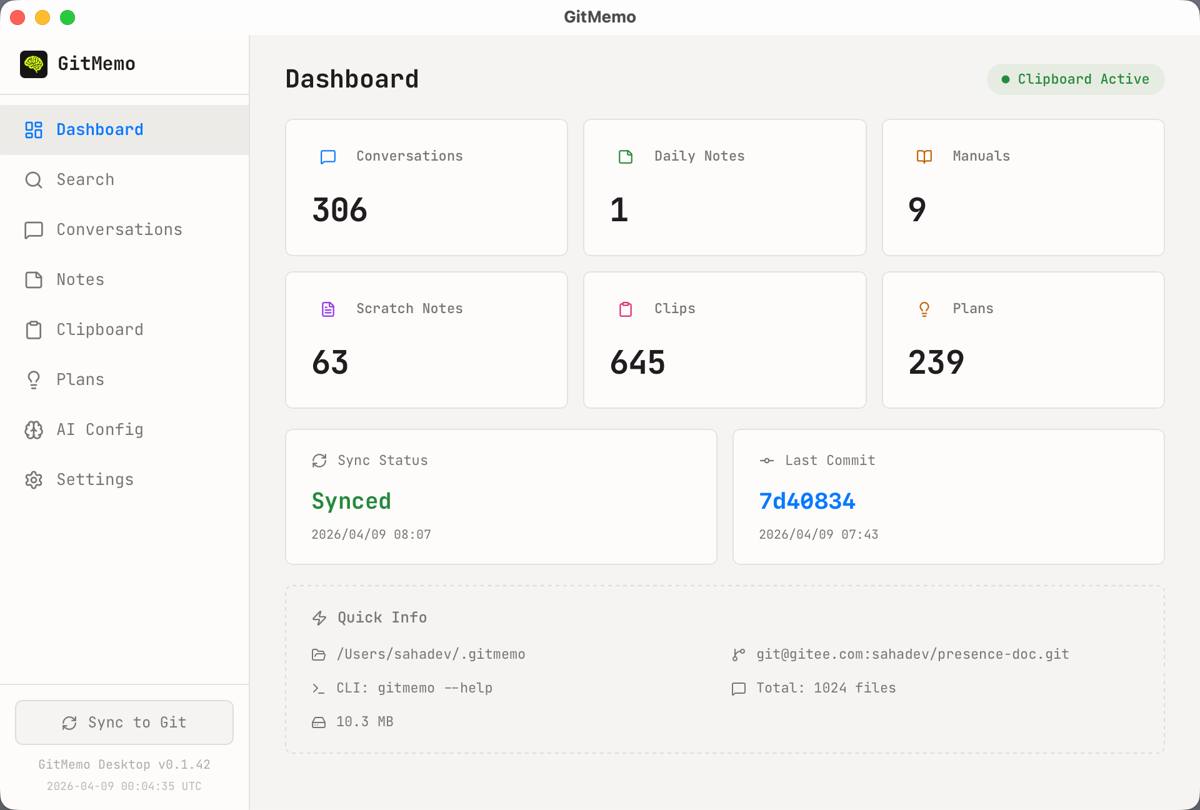
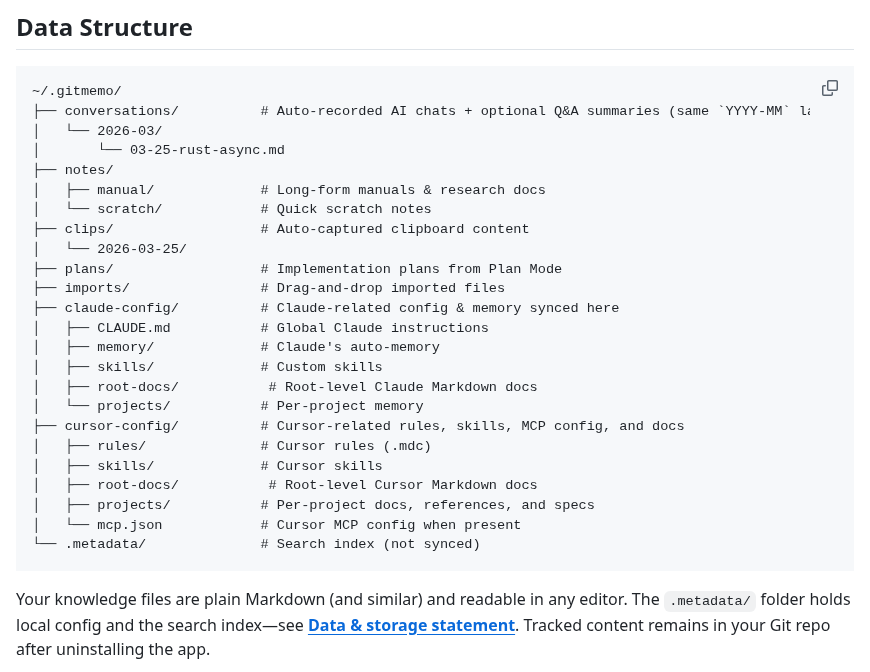
GitMemo part d’un autre constat. Beaucoup d’informations utiles naissent dans des endroits temporaires : conversations avec une IA, textes copiés, captures d’écran. GitMemo les range dans un dépôt Git que vous contrôlez, sous forme de fichiers simples.
Il garde aussi les réglages de vos outils IA : par exemple les instructions générales données à Claude, sa mémoire, ou les règles de l’éditeur de code Cursor. Si vous changez d’ordinateur, votre façon de travailler avec l’IA vous suit.
Attention à un point, qui rejoint notre premier article. Si GitMemo enregistre vos conversations IA et que le dépôt est envoyé sur GitHub, ces conversations sont maintenant stockées aussi chez GitHub. Un dépôt privé n’est visible que par les personnes autorisées, mais il est quand même hébergé ailleurs que chez vous. Et si vous activez la surveillance du presse-papiers, pensez à ce que vous copiez : un mot de passe copié est aussi du texte.
Kherad : un wiki où les auteurs ne voient jamais Git
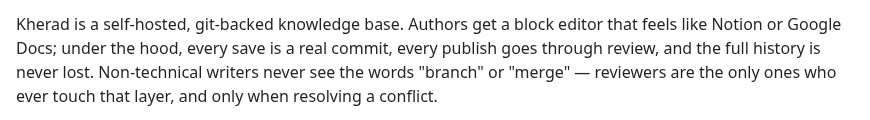
Kherad est un wiki d’entreprise que l’on installe sur son propre serveur. Il ne passe pas par GitHub : il garde son propre dépôt Git, sur ce serveur.
Son idée est très nette. Les auteurs écrivent dans un éditeur qui ressemble à Notion. Ils cliquent sur Save (enregistrer), puis sur Submit for review (soumettre pour relecture). Derrière, chaque clic sur Save crée un vrai commit, et chaque publication passe par une relecture. Mais les auteurs ne voient jamais les mots « branche » ou « merge ».
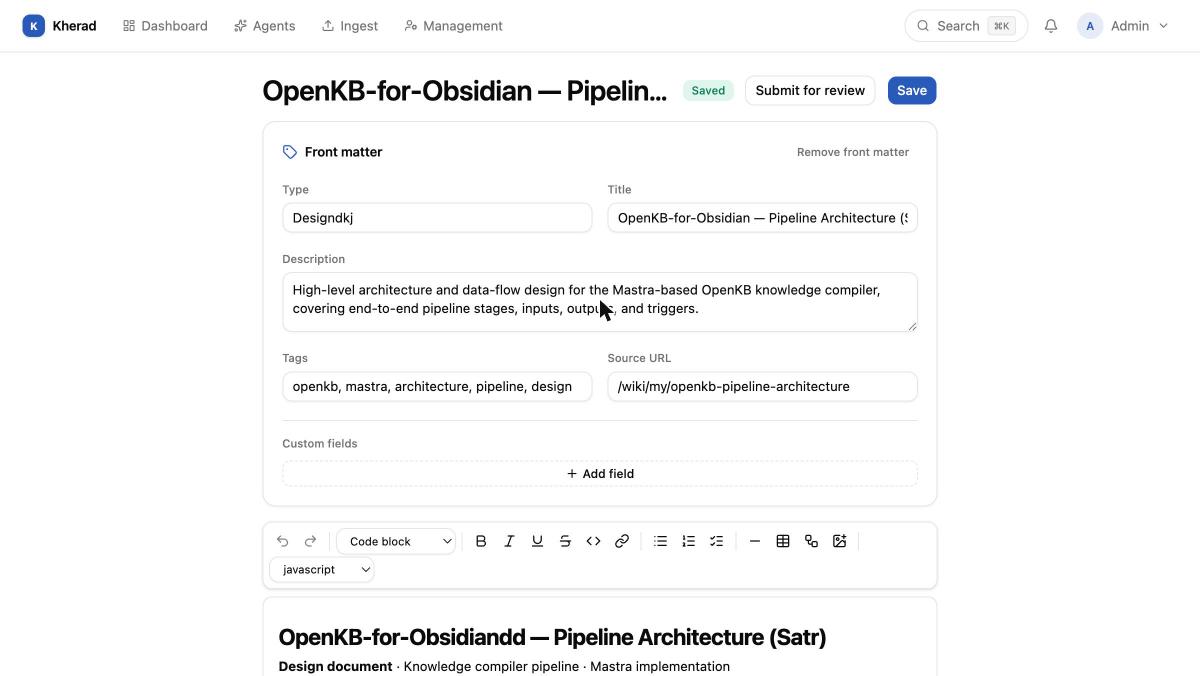
Kherad résout le problème des conflits d’une façon simple : chaque auteur travaille sur sa propre copie, et ce sont les relecteurs qui règlent les rares conflits. Le prix à payer : il faut quelqu’un de technique pour installer et maintenir le serveur.
Ce qu’il faut retenir
Ces trois projets ne sont pas une liste de logiciels à comparer. Ils montrent trois façons de cacher Git : un éditeur qui synchronise tout seul, un outil qui range ce qui est temporaire, un wiki où seuls les relecteurs voient la technique.
Aucun ne supprime les questions de départ : où est stocké le dépôt, qui peut le lire, quelles clés donnent accès, et que se passe-t-il quand deux versions s’opposent. Mais ils montrent que l’on peut avoir l’historique et la durabilité de Git sans demander à tout le monde de devenir développeur.
Nous pouvons créer le dépôt, régler ce qui ne doit jamais y entrer, et écrire les règles de synchronisation pour votre IA. Vous gardez la propriété du dépôt et des accès. Envoyez-nous quelques mots sur votre activité et votre besoin.
À suivre : Donner les clés à une IA : le problème particulier des agents
Vérification
Sources
Je n’y comprends toujours pas grand-chose…
Vous pouvez demander de l’aide dès maintenant, même sans avoir lu tout le guide.
1. Demander à un voisin relais
Une personne près de chez vous vous montre les étapes, puis vous laisse les faire. En expliquant ce qu’elle sait, elle repère aussi ce qui reste flou.
Réseau en préparation. La mise en relation n’est pas encore ouverte. En attendant, vous pouvez suivre ce guide avec une personne de confiance.
2. Demander à mon assistant IA
Copiez cette demande dans votre chatbot. Elle lui donne le sujet et les limites à respecter.
Lire ou sélectionner la demande
3. Nous confier cette tâche Service payant
Nous pouvons faire cette tâche pour vous. Nous décidons ensemble du travail à faire avant de commencer.
Envoyez-nous quelques mots sur votre activité et la tâche à faire, sans document confidentiel.