La réponse courte
Parfois oui, souvent pas sans réfléchir. Tout dépend de quatre choses que l’on mélange facilement : le service traite la donnée, il peut la conserver, il peut l’utiliser pour entraîner un modèle, et l’assistant peut en garder une trace comme mémoire.
Les réglages de ChatGPT, le chat éphémère ou la Zero Data Retention changent certains de ces points, pas tous. Avant d’envoyer un fichier, posez-vous une seule question : cette donnée a-t-elle le droit de quitter mon ordinateur ? Si oui, vers qui, pour combien de temps et dans quelles conditions ?
\nIci, nous utilisons « données sensibles » au sens courant : toute information personnelle, confidentielle ou professionnelle dont la diffusion pourrait poser problème.
Cela vous semble déjà trop compliqué ? Faites-vous aider.
Deux situations très ordinaires
Premier cas. Un chercheur en mathématiques travaille depuis six mois sur un résultat. Il n’est pas encore publié. Un soir, il bloque sur une étape et demande de l’aide à une IA. La discussion l’aide beaucoup. Puis il se pose une question un peu désagréable : est-ce que je viens de donner mon travail à quelqu’un ?
Deuxième cas. Une personne qui travaille dans la finance reçoit un fichier Excel. Elle veut que l’IA l’aide à repérer des anomalies. Mais le fichier contient peut-être des chiffres internes, et des noms de clients.
Quatre choses qui n’ont rien à voir
Quand on dit « l’IA a mes données », on peut parler de quatre choses très différentes.
Traiter. Pour vous répondre, le modèle doit lire votre texte. S’il tourne sur un serveur, votre texte voyage jusqu’à ce serveur. C’est comme un traducteur : il doit lire la lettre pour la traduire.
Conserver. Après la réponse, le service peut garder une copie : dans votre historique, dans des journaux techniques, ou pour la sécurité. Le traducteur peut garder une photocopie de la lettre dans un tiroir.
Entraîner. Une conversation peut servir plus tard à améliorer un futur modèle. Cette fois, le traducteur apprend quelque chose de votre lettre et s’en sert pour mieux travailler avec d’autres clients.
Mémoriser. Certains assistants gardent des informations sur vous pour personnaliser les réponses suivantes : votre métier, vos préférences, vos projets. Le traducteur se souvient que vous préférez un ton formel.
Ces quatre points sont réglés séparément. Désactiver l’un ne désactive pas automatiquement les autres. C’est la principale source de malentendus.
Ce que vous pouvez régler dans ChatGPT
Nous prenons ChatGPT comme exemple parce qu’il est très utilisé. Les règles ci-dessous viennent de la documentation officielle d’OpenAI, vérifiée le 30 septembre 2026. Elles concernent les comptes personnels (Free, Go, Plus, Pro). Les espaces de travail d’entreprise ont leurs propres règles.
Désactiver l’entraînement
Dans Paramètres → Contrôles des données, l’option « Améliorer le modèle pour tous » peut être désactivée. Le libellé exact peut légèrement changer selon la langue et l’appareil.
Quand elle est désactivée, vos nouvelles conversations ne servent plus à entraîner les modèles d’OpenAI. Mais elles restent dans votre historique. Elles ne sont ni supprimées ni cachées.
Un détail que peu de gens connaissent : si vous cliquez sur 👍 ou 👎 pour donner votre avis sur une réponse, toute la conversation concernée peut être utilisée pour l’entraînement, même avec l’option désactivée. Pour un sujet sensible, évitez donc ces boutons.
Le chat éphémère
Le chat éphémère (Temporary Chat en anglais) se lance avant de commencer la conversation. Tant qu’il reste éphémère :
- il n’apparaît pas dans votre historique ;
- il ne crée pas de nouvelle mémoire ;
- il ne sert pas à entraîner les modèles.
Mais OpenAI peut en garder une copie jusqu’à 30 jours pour des raisons de sécurité. Et attention à un point récent : au début du chat, vous choisissez entre Personnalisé et Non personnalisé. En mode personnalisé, le chat éphémère peut utiliser vos mémoires et instructions existantes. Il ne les modifie pas, mais il peut les lire.
Si vous enregistrez ensuite le chat éphémère, il devient une conversation normale, avec les règles normales.
Supprimer une conversation
Une conversation supprimée disparaît tout de suite de votre compte. OpenAI prévoit de l’effacer de ses systèmes sous 30 jours, sauf obligation de sécurité ou obligation légale de la garder plus longtemps.
Zero Data Retention : zéro conservation, pas zéro traitement
Dans les offres pour développeurs et entreprises (l’API, c’est-à-dire l’accès aux modèles par un programme et non par l’application ChatGPT), les règles sont différentes. Par défaut, les données envoyées à l’API d’OpenAI ne servent pas à entraîner les modèles. En revanche, OpenAI tient des journaux de surveillance des abus : des registres techniques qui servent à repérer les mauvais usages. Ils peuvent contenir vos demandes et les réponses, pendant 30 jours au maximum.
La Zero Data Retention (ZDR, « aucune conservation des données ») enlève votre contenu de ces journaux, pour les services qui y ont droit. Elle n’est pas automatique : il faut en faire la demande et être accepté par OpenAI. Et elle ne couvre pas toutes les fonctions. Celles qui doivent garder un état, par exemple des conversations enregistrées côté serveur ou des fichiers, peuvent continuer à conserver des données.
Retenez surtout ceci : zéro conservation ne veut pas dire zéro traitement. Votre texte part quand même sur les serveurs du fournisseur. Le serveur doit le lire pour produire la réponse. La ZDR promet qu’il n’en garde pas de copie après, pour les services couverts. Elle ne promet pas que le texte ne quitte jamais votre ordinateur.
Mistral propose aussi une option ZDR sur son API, sur demande et pour des appels sans état seulement. Elle ne couvre pas son application de chat.
Le modèle local : une autre question
Il existe des modèles que l’on peut faire tourner sur son propre ordinateur, ou sur les serveurs de son entreprise. Dans ce cas, le texte ne part pas chez un fournisseur. Il reste sur une machine que vous contrôlez.
Pour une donnée qui ne doit absolument pas sortir, c’est parfois la seule solution acceptable. Mais « local » ne règle pas tout. Un modèle local est souvent moins puissant. Il faut l’installer, le mettre à jour et protéger la machine. Et si cette machine est mal protégée, la donnée n’est pas plus en sécurité qu’ailleurs.
À l’inverse, beaucoup de données sensibles peuvent aller dans un service en ligne, si le contrat, les réglages et la durée de conservation conviennent. « Donnée sensible = modèle local » est une règle trop simple.
Un schéma pour s’y retrouver
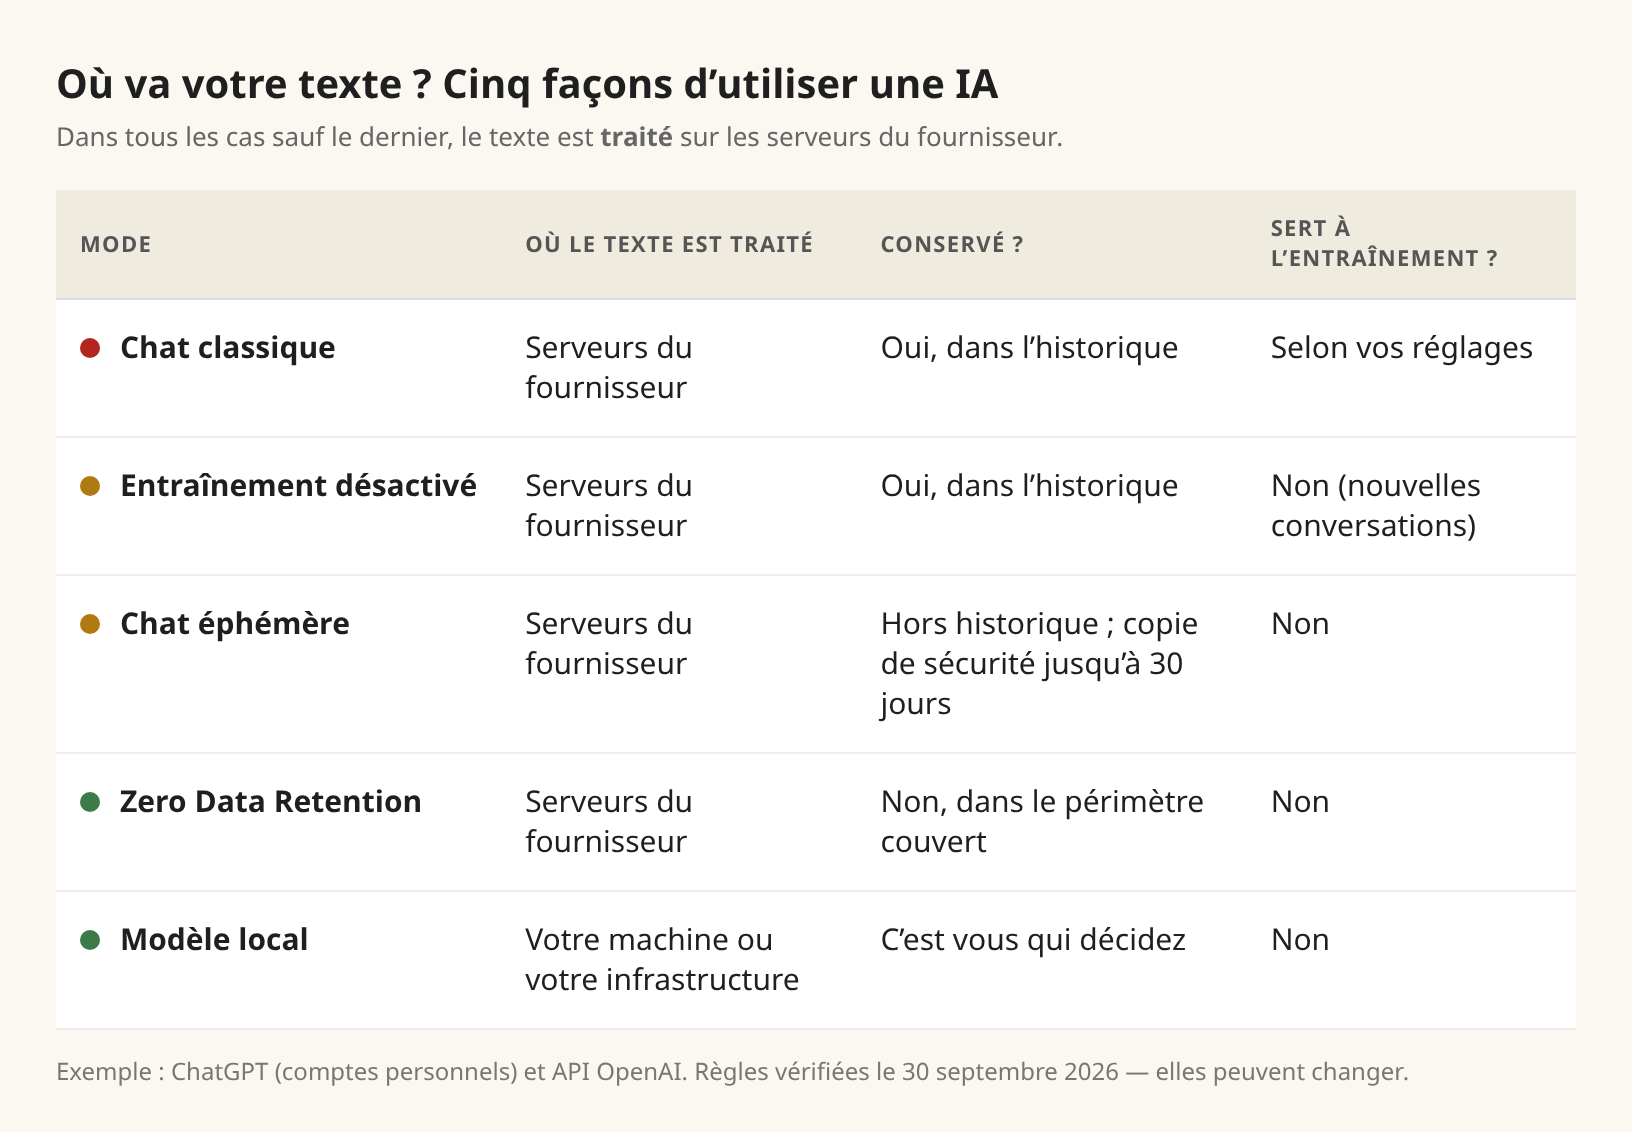
- Chat classique
- Traité sur les serveurs du fournisseur. Conservé dans l’historique. Peut servir à l’entraînement selon vos réglages.
- Entraînement désactivé
- Les nouvelles conversations ne servent plus à l’entraînement. Elles restent conservées dans l’historique.
- Chat éphémère
- Pas dans l’historique, pas de nouvelle mémoire, pas d’entraînement. Une copie peut être gardée jusqu’à 30 jours pour la sécurité.
- Zero Data Retention
- Traité dans le cloud, mais le contenu n’est pas conservé dans le périmètre couvert. Sur demande, surtout pour l’API.
- Modèle local
- Traité sur une machine ou une infrastructure que vous contrôlez. La sécurité dépend alors de vous.
La question à se poser avant d’envoyer
Revenons à nos deux personnes.
L’analyste financière, elle, doit d’abord demander : ai-je le droit de faire sortir ce fichier ? Son entreprise a peut-être déjà un outil approuvé, avec un contrat adapté. Ou une règle simple : pas de données clients dans un outil grand public. Elle peut aussi retirer les noms et garder seulement les chiffres dont l’IA a besoin.
Dans les deux cas, la même question fonctionne mieux que n’importe quelle règle toute faite :
Est-ce que cette donnée a le droit de quitter mon ordinateur ? Si oui, vers qui, pour combien de temps et dans quelles conditions ?
Si vous ne savez pas répondre à « vers qui » et « pour combien de temps », vous avez trouvé ce qu’il faut vérifier avant d’envoyer.
À suivre : Votre IA vous connaît. Mais où vit votre travail ?
Vérification
Sources
Je n’y comprends toujours pas grand-chose…
Vous pouvez demander de l’aide dès maintenant, même sans avoir lu tout le guide.
1. Demander à un voisin relais
Une personne près de chez vous vous montre les étapes, puis vous laisse les faire. En expliquant ce qu’elle sait, elle repère aussi ce qui reste flou.
Réseau en préparation. La mise en relation n’est pas encore ouverte. En attendant, vous pouvez suivre ce guide avec une personne de confiance.
2. Demander à mon assistant IA
Copiez cette demande dans votre chatbot. Elle lui donne le sujet et les limites à respecter.
Lire ou sélectionner la demande
3. Nous confier cette tâche Service payant
Nous pouvons faire cette tâche pour vous. Nous décidons ensemble du travail à faire avant de commencer.
Envoyez-nous quelques mots sur votre activité et la tâche à faire, sans document confidentiel.